Traduction de la langue des signes en voix en temps réel
Projet de fin d'études en génie informatique · UPV · 2024–2025. Un pipeline fonctionnel des signes à la voix : 250 signes ASL · ~15 FPS de capture · Coral Edge TPU · 8/9 exigences fonctionnelles.
Présentation
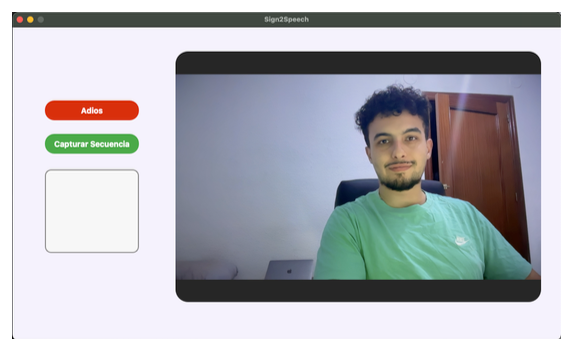
J’ai développé Sign2Speech, un prototype fonctionnel capable de capturer des gestes en langue des signes à l’aide d’une caméra, de reconnaître des signes individuels, de reconstruire de courtes phrases en langage naturel et de les convertir en voix.
Le système combine MediaPipe Holistic, la classification de séquences par deep learning, un modèle de langage dans le cloud et une synthèse vocale locale, le pipeline de reconnaissance étant conçu pour être déployé sur une Google Coral Dev Board.
Ce projet a été réalisé dans le cadre de mon projet de fin d’études en génie informatique à l’Universitat Politècnica de València.
Le problème
Les barrières de communication peuvent être particulièrement marquées dans les services publics comme les hôpitaux, les mairies et les autres points d’accueil du public. Ce projet explore comment la vision par ordinateur et l’edge computing peuvent être combinés pour créer une interface accessible entre la langue des signes et la communication orale.
La difficulté technique vient du fait qu’un signe se déroule dans le temps et combine les mains, le corps et le visage, que des signes visuellement proches se confondent facilement et que le système doit fonctionner sur un matériel edge aux ressources limitées.
Architecture du système
Le pipeline complet suit ce flux :
Caméra → Extraction des landmarks → Classification des gestes → Génération de langage → Synthèse vocale
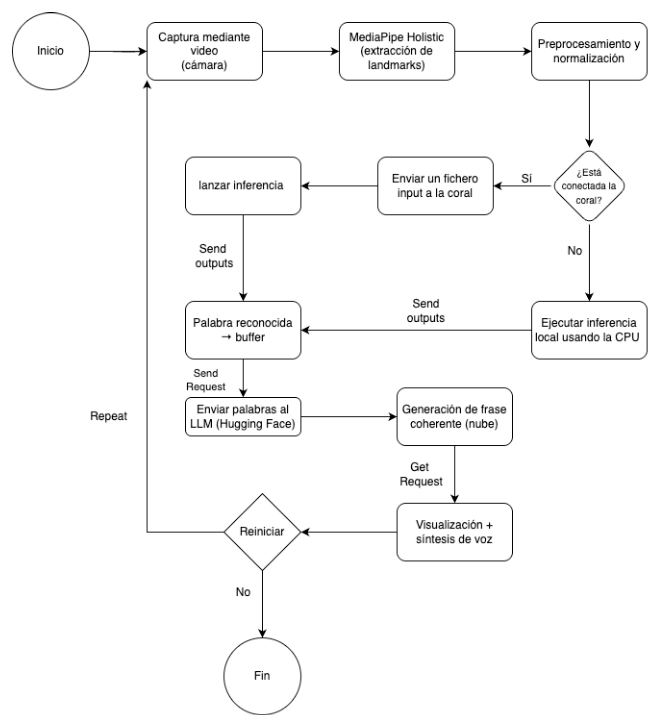
Plutôt que de traiter la vidéo brute tout au long du pipeline, le système utilise MediaPipe Holistic pour extraire des landmarks structurés du corps, des mains et du visage. Ces séquences temporelles de landmarks sont ensuite traitées par le modèle de reconnaissance des gestes.
Les mots reconnus sont transmis à un composant de génération de langage hébergé via Hugging Face, qui les reconstruit en une courte phrase en langage naturel. Enfin, la phrase est convertie en voix localement grâce à un moteur de synthèse vocale (Text-to-Speech).
Cette conception modulaire permet de remplacer chaque composant indépendamment et d’adapter le système à différents environnements d’exécution.
Modèle et méthodologie
Représentation visuelle des gestes
La première étape convertit l’image de la caméra en représentations structurées des mouvements de l’utilisateur.
J’ai utilisé MediaPipe Holistic pour extraire des landmarks du corps, des mains et du visage. Cela fournit une représentation compacte du geste sans nécessiter de capteurs spécialisés portés par l’utilisateur.
Les séquences obtenues contiennent les coordonnées tridimensionnelles des landmarks (x, y, z) au fil du temps et constituent l’entrée des modèles de classification.
Reconnaissance des gestes avec des Transformers
L’architecture de reconnaissance initiale reposait sur des Transformers avec attention multi-têtes.
Les séquences de landmarks étaient projetées dans un espace d’embeddings puis traitées par un encodage positionnel et des mécanismes d’attention afin de capturer les relations temporelles et spatiales entre les différentes parties du geste.
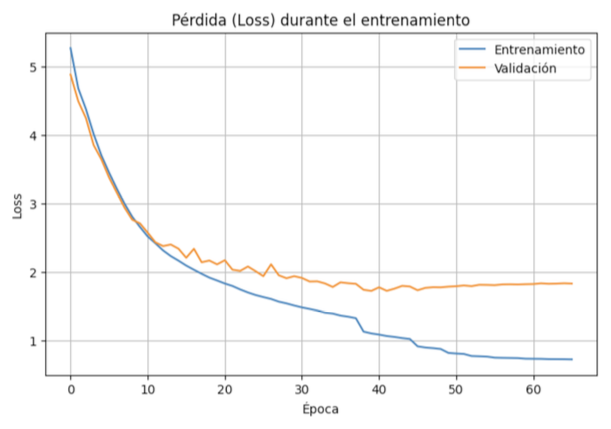
Le Transformer initial a atteint plus de 90 % de précision à l’entraînement, ce qui a démontré la viabilité de la représentation et de l’approche de modélisation. Toutefois, obtenir de bonnes performances de classification n’était qu’une partie du problème : le modèle devait aussi pouvoir être déployé sur un matériel edge aux ressources limitées.
Génération de langage et voix
Une fois les signes individuels classés, les mots reconnus sont envoyés à un modèle de langage qui construit une phrase courte et cohérente.
Le texte obtenu est ensuite transmis à un composant local de synthèse vocale basé sur pyttsx3, ce qui permet de produire la sortie vocale sans recourir à un service cloud supplémentaire.
Entraînement
Le projet a d’abord exploré le jeu de données WLASL, mais la qualité de ses vidéos, le nombre limité d’exemples par classe et ses exigences de prétraitement le rendaient peu adapté au pipeline visé.
J’ai donc travaillé avec le jeu de données de Google fondé sur des landmarks, qui compte 250 classes de signes. Il fournit des séquences de gestes déjà extraites, ce qui a permis de concentrer le projet sur la représentation temporelle et le développement du modèle.
Les données ont été normalisées, alignées temporellement et converties en un jeu de données structuré adapté à l’entraînement de modèles de deep learning.
Déploiement edge
Concevoir pour l’Edge AI
Le Transformer ne pouvait pas être déployé directement sur la Coral Edge TPU.
Les principaux obstacles étaient des opérations non prises en charge, des formes de tenseurs dynamiques ainsi que la taille et la complexité de l’architecture. Plutôt que de traiter cela comme une limite purement logicielle, j’ai repensé le modèle en fonction des contraintes du matériel cible.
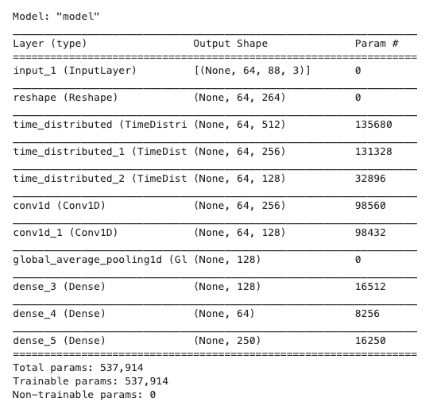
L’architecture finale a remplacé le Transformer par une combinaison plus légère de :
- Couches TimeDistributed Dense
- Couches Conv1D
- GlobalAveragePooling1D
- Couches Dense de classification
- Conversion en TensorFlow Lite
- Compilation pour l’Edge TPU
Le modèle obtenu a été converti et compilé avec succès pour une exécution sur la Coral Edge TPU.
Inférence résiliente
L’application a été conçue avec deux chemins d’inférence.
Lorsqu’un appareil Coral est disponible, le système envoie le tenseur prétraité à la Coral Edge TPU pour l’inférence. Si l’appareil n’est pas disponible, le même modèle TensorFlow Lite peut être exécuté localement sur le CPU.
Cette architecture de repli rend le prototype portable entre les machines de développement et les déploiements edge, tout en évitant une panne complète du système lorsque l’accélérateur n’est pas disponible.
Résultats
Le prototype final démontre l’ensemble du pipeline de traduction, de la capture du geste jusqu’à la sortie vocale.
Validation fonctionnelle
Le système réalisé a démontré avec succès :
- La capture de gestes en temps réel par caméra
- L’extraction de landmarks avec MediaPipe
- La classification des gestes au niveau du mot
- La génération de phrases en langage naturel
- La conversion du texte en voix
- L’inférence sur CPU
- L’inférence sur la Coral Edge TPU
- Le basculement automatique entre les backends d’inférence
L’évaluation fonctionnelle a confirmé 8 des 9 exigences fonctionnelles définies. L’exigence restante, une inférence entièrement locale sur la Coral Dev Board, n’a pas été considérée comme pleinement satisfaite lors de l’évaluation finale.
Performances
Le pipeline de la caméra a atteint environ 15 FPS, une capture des gestes suffisamment fluide pour le prototype.
L’inférence sur CPU est restée sous 1 seconde par séquence, tandis que le flux distant complet avec la Coral, comprenant le transfert du tenseur, l’inférence et la récupération du résultat, prenait quelques secondes.
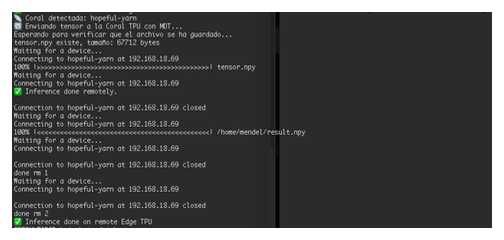
Ces résultats ont démontré la faisabilité technique, même si le système final n’était pas encore assez rapide ni assez précis pour un déploiement réel sans restriction.
Compromis d’ingénierie
L’un des principaux enseignements du projet a été le compromis entre complexité du modèle, performance de reconnaissance et compatibilité avec le matériel edge.
L’architecture Transformer, plus expressive, a obtenu de bonnes performances à l’entraînement mais ne pouvait pas être déployée efficacement sur l’Edge TPU cible. L’architecture convolutive 1D, plus légère, a résolu le problème du déploiement au prix de la précision de classification.
C’est devenu l’une des leçons d’ingénierie centrales du projet : un modèle performant dans un environnement de développement n’est pas forcément le meilleur modèle pour une cible de production aux ressources limitées.
Limites
Le projet est volontairement présenté comme une preuve de concept et non comme un système d’accessibilité prêt pour la production.
Le classifieur final commettait encore des erreurs, notamment sur des gestes visuellement proches ou mal exécutés. L’architecture réduite imposée par la compatibilité avec l’Edge TPU limitait sa capacité à modéliser des relations temporelles complexes.
Le prototype a également été entraîné sur la langue des signes américaine (ASL) plutôt que sur la langue des signes espagnole (LSE), principalement faute d’un jeu de données public de LSE suffisamment complet pour le projet.
Enfin, le système n’a pas été évalué formellement avec des personnes sourdes ni avec des experts de la langue des signes : son utilisabilité réelle et son impact sur l’accessibilité restent donc à valider.
Technologies utilisées
Python · TensorFlow · TensorFlow Lite · MediaPipe Holistic · Deep Learning · Vision par ordinateur · Conv1D · Transformers · Google Coral Edge TPU · Hugging Face · FastAPI · PyQt · pyttsx3 · NumPy · Pandas · Scikit-learn · Google Cloud Platform
Contexte de recherche
Ce projet se situe à l’intersection de la vision par ordinateur, du deep learning, de l’edge computing et des technologies d’accessibilité.
Au-delà de la réalisation d’un prototype fonctionnel, le projet a exploré un problème pratique important en ingénierie ML : comment faire passer un modèle issu de la recherche d’un environnement d’entraînement flexible à un appareil edge aux ressources limitées, tout en conservant un système complet et utilisable.
L’architecture obtenue pose les bases de travaux futurs : des vocabulaires plus larges, l’adaptation à la langue des signes espagnole, une meilleure modélisation temporelle, une plus grande robustesse face à l’environnement et une validation avec de vrais utilisateurs.