Traducción de lengua de signos a voz en tiempo real
Trabajo Fin de Grado en Ingeniería Informática · UPV · 2024–2025. Un pipeline funcional de signos a voz: 250 signos ASL · ~15 FPS de captura · Coral Edge TPU · 8/9 requisitos funcionales.
Resumen
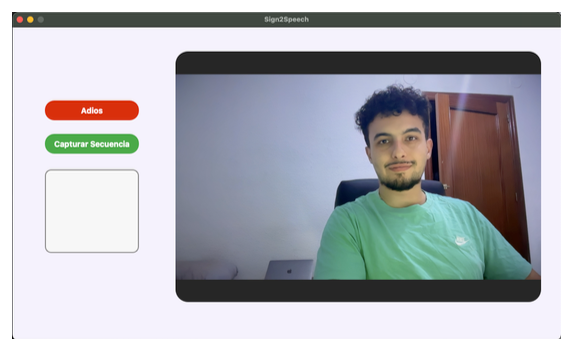
Desarrollé Sign2Speech, un prototipo funcional capaz de capturar gestos de lengua de signos con una cámara, reconocer signos individuales, reconstruir frases cortas en lenguaje natural y convertirlas en voz.
El sistema combina MediaPipe Holistic, clasificación de secuencias con deep learning, un modelo de lenguaje en la nube y síntesis de voz local, con el pipeline de reconocimiento diseñado para desplegarse en una Google Coral Dev Board.
El proyecto se desarrolló como mi Trabajo Fin de Grado en Ingeniería Informática en la Universitat Politècnica de València.
El problema
Las barreras de comunicación pueden ser especialmente importantes en servicios públicos como hospitales, ayuntamientos y otros puntos de atención al ciudadano. Este proyecto explora cómo combinar la visión por computador y el edge computing para crear una interfaz accesible entre la lengua de signos y la comunicación oral.
El reto técnico es que un signo se desarrolla en el tiempo y combina manos, cuerpo y cara, los signos visualmente parecidos se confunden con facilidad y el sistema debe ejecutarse en hardware edge con recursos limitados.
Arquitectura del sistema
El pipeline completo sigue este flujo:
Cámara → Extracción de landmarks → Clasificación de gestos → Generación de lenguaje → Síntesis de voz
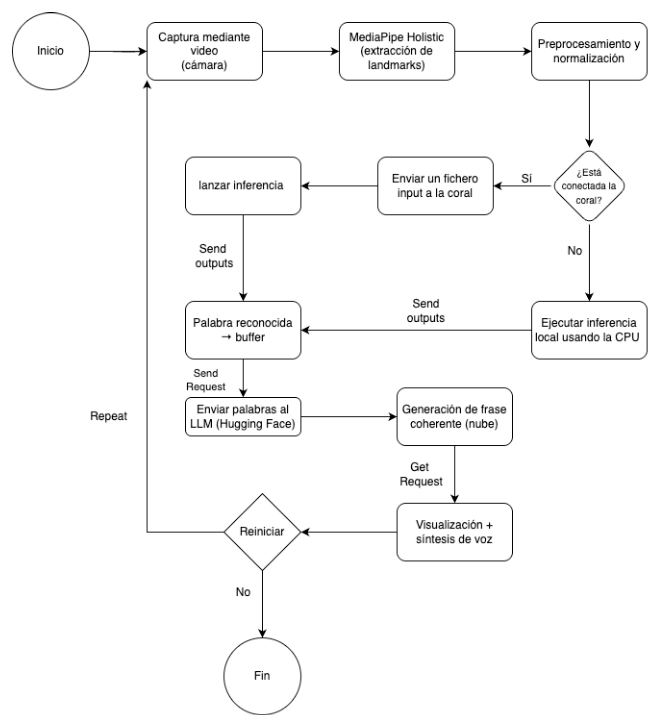
En lugar de procesar vídeo en bruto a lo largo de todo el pipeline, el sistema utiliza MediaPipe Holistic para extraer landmarks estructurados del cuerpo, las manos y la cara. Estas secuencias temporales de landmarks son las que procesa después el modelo de reconocimiento de gestos.
Las palabras reconocidas se envían a un componente de generación de lenguaje alojado en Hugging Face, que las reconstruye en una frase corta en lenguaje natural. Por último, la frase se convierte en voz de forma local mediante un motor de síntesis de voz (Text-to-Speech).
Este diseño modular hace que cada componente pueda sustituirse de forma independiente y permite al sistema adaptarse a distintos entornos de ejecución.
Modelo y metodología
Representación visual del gesto
La primera etapa convierte la imagen de la cámara en representaciones estructuradas de los movimientos del usuario.
Utilicé MediaPipe Holistic para extraer landmarks del cuerpo, las manos y la cara. Esto ofrece una representación compacta del gesto sin necesidad de sensores especializados que el usuario tenga que llevar puestos.
Las secuencias resultantes contienen coordenadas tridimensionales de los landmarks (x, y, z) a lo largo del tiempo, que forman la entrada de los modelos de clasificación.
Reconocimiento de gestos con Transformers
La arquitectura de reconocimiento inicial se basó en Transformers con atención multi-cabeza.
Las secuencias de landmarks se proyectaron a un espacio de embeddings y se procesaron con codificación posicional y mecanismos de atención para capturar las relaciones temporales y espaciales entre las distintas partes del gesto.
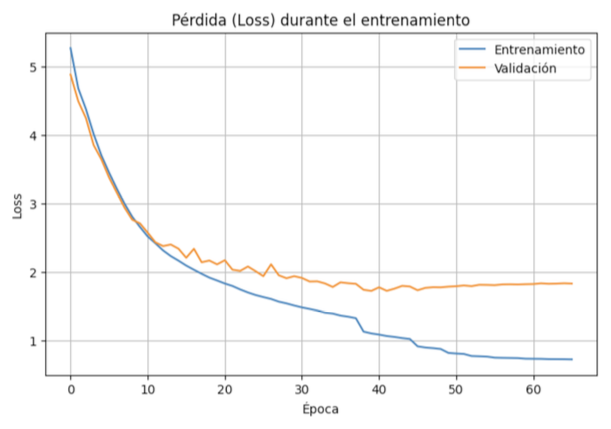
El Transformer inicial alcanzó más de un 90 % de precisión en entrenamiento, lo que demostró la viabilidad de la representación y del enfoque de modelado. Sin embargo, lograr un buen rendimiento de clasificación era solo una parte del problema: el modelo también tenía que poder desplegarse en hardware edge con recursos limitados.
Generación de lenguaje y voz
Una vez clasificados los signos individuales, las palabras reconocidas se envían a un modelo de lenguaje que construye una frase corta y coherente.
El texto resultante pasa después a un componente local de síntesis de voz basado en pyttsx3, de modo que la salida hablada se genera sin necesidad de otro servicio en la nube para la síntesis de voz.
Entrenamiento
El proyecto exploró inicialmente el dataset WLASL, pero la calidad de sus vídeos, el número limitado de muestras por clase y sus requisitos de preprocesamiento lo hacían poco práctico para el pipeline objetivo.
Por ello trabajé con el dataset de Google basado en landmarks, con 250 clases de signos, que proporciona secuencias de gestos ya extraídas y permitió centrar el proyecto en la representación temporal y el desarrollo del modelo.
Los datos se normalizaron, se alinearon temporalmente y se convirtieron en un dataset estructurado apto para entrenar modelos de deep learning.
Despliegue en el edge
Diseño para Edge AI
El Transformer no podía desplegarse directamente en la Coral Edge TPU.
Los principales obstáculos eran operaciones no soportadas, formas de tensor dinámicas y el tamaño y la complejidad de la arquitectura. En lugar de tratarlo como una limitación puramente de software, rediseñé el modelo en torno a las restricciones del hardware objetivo.
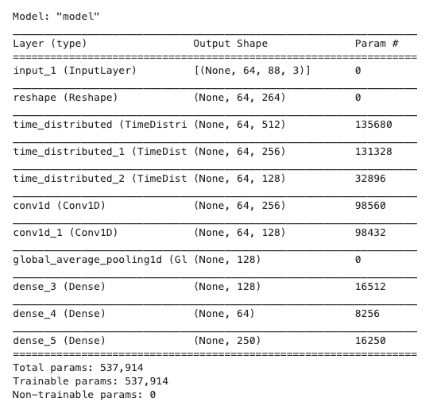
La arquitectura final sustituyó el Transformer por una combinación más ligera de:
- Capas TimeDistributed Dense
- Capas Conv1D
- GlobalAveragePooling1D
- Capas Dense de clasificación
- Conversión a TensorFlow Lite
- Compilación para Edge TPU
El modelo resultante se convirtió y compiló correctamente para ejecutarse en la Coral Edge TPU.
Inferencia resiliente
La aplicación se diseñó con dos rutas de inferencia.
Cuando hay un dispositivo Coral disponible, el sistema envía el tensor preprocesado a la Coral Edge TPU para la inferencia. Si el dispositivo no está disponible, el mismo modelo de TensorFlow Lite puede ejecutarse localmente en la CPU.
Esta arquitectura de respaldo hace que el prototipo sea portable entre equipos de desarrollo y despliegues edge, y evita un fallo completo del sistema cuando el acelerador no está disponible.
Resultados
El prototipo final demuestra el pipeline completo de traducción, desde la captura del gesto hasta la salida hablada.
Validación funcional
El sistema implementado demostró con éxito:
- Captura de gestos en tiempo real con cámara
- Extracción de landmarks con MediaPipe
- Clasificación de gestos a nivel de palabra
- Generación de frases en lenguaje natural
- Conversión de texto a voz
- Inferencia en CPU
- Inferencia en la Coral Edge TPU
- Cambio automático entre backends de inferencia
La evaluación funcional confirmó 8 de los 9 requisitos funcionales definidos. El requisito restante, la inferencia totalmente local en la Coral Dev Board, no se consideró completamente satisfecho en la evaluación final.
Rendimiento
El pipeline de la cámara alcanzó aproximadamente 15 FPS, una captura de gestos suficientemente fluida para el prototipo.
La inferencia en CPU se mantuvo por debajo de 1 segundo por secuencia, mientras que el flujo remoto completo con la Coral, incluida la transferencia del tensor, la inferencia y la recuperación del resultado, tardaba unos pocos segundos.
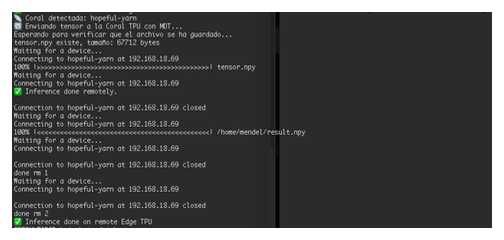
Estos resultados demostraron la viabilidad técnica, aunque el sistema final aún no era lo bastante rápido ni preciso para un despliegue real sin restricciones.
Compromiso de ingeniería
Una de las principales conclusiones del proyecto fue el compromiso entre complejidad del modelo, rendimiento de reconocimiento y compatibilidad con el hardware edge.
La arquitectura Transformer, más expresiva, obtuvo un buen rendimiento en entrenamiento, pero no podía desplegarse de forma eficiente en la Edge TPU objetivo. La arquitectura convolucional 1D, más ligera, resolvió el problema del despliegue a costa de la precisión de clasificación.
Esta fue una de las lecciones de ingeniería centrales del proyecto: un modelo que funciona bien en un entorno de desarrollo no es necesariamente el mejor modelo para un entorno de producción con recursos limitados.
Limitaciones
El proyecto se presenta deliberadamente como una prueba de concepto y no como un sistema de accesibilidad listo para producción.
El clasificador final todavía cometía errores, sobre todo con gestos visualmente parecidos o mal ejecutados. La arquitectura reducida que exigía la compatibilidad con la Edge TPU limitaba su capacidad para modelar relaciones temporales complejas.
Además, el prototipo se entrenó con lengua de signos americana (ASL) y no con lengua de signos española (LSE), principalmente por la falta de un dataset público de LSE lo bastante completo para el proyecto.
Por último, el sistema no se evaluó formalmente con personas sordas ni con expertos en lengua de signos, por lo que su usabilidad real y su impacto en accesibilidad están aún por validar.
Tecnologías utilizadas
Python · TensorFlow · TensorFlow Lite · MediaPipe Holistic · Deep Learning · Visión por computador · Conv1D · Transformers · Google Coral Edge TPU · Hugging Face · FastAPI · PyQt · pyttsx3 · NumPy · Pandas · Scikit-learn · Google Cloud Platform
Contexto de la investigación
Este proyecto se sitúa en la intersección de la visión por computador, el deep learning, el edge computing y la tecnología de accesibilidad.
Más allá de construir un prototipo funcional, el proyecto abordó un problema práctico importante en ingeniería de ML: cómo llevar un modelo de investigación desde un entorno de entrenamiento flexible a un dispositivo edge con recursos limitados, manteniendo un sistema completo y usable.
La arquitectura resultante sienta las bases para trabajo futuro: vocabularios más amplios, adaptación a la lengua de signos española, mejor modelado temporal, mayor robustez frente al entorno y validación con usuarios reales.